Instrumentation de Rust sur AWS

Publié le rustawsxraylambda
Rust, c’est génial. Et Rust pour les projets serverless, c’est encore plus génial. C’est la conviction profonde que j’ai acquise dès mes premiers pas en Rust, il y a plus de 3 ans, après avoir codé mes lambdas en Python pendant 7 ans avant ça. Je ne reviendrai pas ici sur les raisons qui m’ont fait tomber amoureux : j’ai déjà fait une conférence entière sur le sujet en 2024. Parlons plutôt d’une frustration qui m’a titillé pendant longtemps : l’instrumentation avec X-Ray.
Instrumenter sa Lambda Rust avec X-Ray #
En informatique, quand on cherche à accomplir quelque chose et qu’on a été élevé dans les temps immémoriaux qui précédaient l’IA 🤖, on suit un mantra : RTFM.
Rust est officiellement supporté par AWS Lambda depuis longtemps, donc une petite recherche et on tombe rapidement sur la doc :
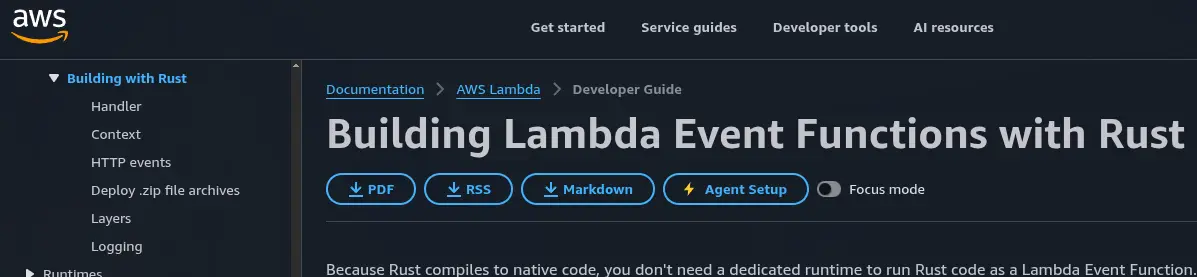
À voir le menu de gauche, le Tracing semble manquer… Petite comparaison avec celui de Python pour en avoir le cœur net :
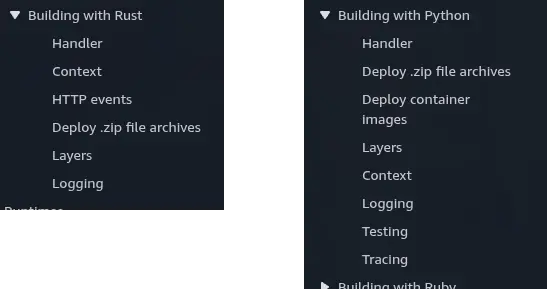
Damned ! Et ce n’est pas juste un oubli dans le menu : si vous lisez d’un bout à l’autre la doc Rust sur Lambda, vous pourriez croire que la traçabilité est une légende, elle n’est tout simplement jamais évoquée.
Et… c’est grave ? #
Oui !
La traçabilité (avec X-Ray ou autre), ça n’est pas forcément très important pour un petit projet démo avec une API Gateway et 3 Lambdas. Mais dans un contexte d’entreprise, avec des architectures serverless complexes, des exigences de performances, des métriques à suivre, des debugs à faire et des clients qui râlent quand ça ne marche pas ; ça devient vite indispensable.
Or, je me fais l’avocat de l’utilisation de Rust pour tous les projets serverless (ou pas d’ailleurs) des entreprises. Je l’érige en langage d’avenir, le Next Level, celui qui soutiendra notre socle technologique pour les 80 prochaines années…
Donc oui : pas de traçabilité sur AWS, je considère que ça la fout mal et que c’est un frein sérieux à l’adoption de Rust pour les projets d’entreprise.
La communauté propose-t-elle une solution ? #
Notez que la traçabilité d’une application écrite en Rust est tout à fait possible en soi et même plutôt facile, notamment grâce au fameux crate tracing. L’export vers des systèmes d’observabilité se fait également bien avec l’écosystème OpenTelemetry.
Mais une bonne intégration avec l’éco-système AWS va plus loin que ça. Dans les grandes lignes, on a 2 besoins :
- fournir une interface permettant de transformer le tracing natif de Rust en des segments X-Ray ;
- instrumenter les SDK AWS pour qu’ils génèrent automatiquement des traces pour les communications avec des services comme S3 ou DynamoDB (par exemple).
Sur ces deux points, début 2026, c’était le néant. J’ai donc pris sur moi de proposer une solution.
La solution que je propose #
Instrumentation #
Comme tracing est super ancré dans la communauté Rust et qu’il est utilisé en interne par les SDK AWS, je m’appuie dessus pour la partie instrumentation pure du code applicatif. Il a en plus le bon goût d’être super simple à utiliser :
// This is NOT traced
fn do_stuff() {
    todo!()
}

// This IS traced
#[tracing::instrument]
fn do_traced_stuff() {
    todo!()
}
Une simple annotation (une macro procédurale en fait) au dessus d’une fonction, et hop, ça devient un span[1] de tracing avec les timings et tout. Pas besoin de ré-inventer cette partie, je ne ferai jamais mieux.
OpenTelemetry (OTel) #
Il y a plusieurs raisons de s’intéresser à OpenTelemetry :
- l’avenir d’AWS X-Ray est incertain, et dans l’action illisible et chaotique d’AWS sur ce sujet[2] la seule chose qui semble claire c’est qu’OpenTelemetry fait partie de cet avenir ;
- bien qu’AWS X-Ray soit mon objectif primaire, l’ensemble de l’industrie de l’observabilité s’interface avec OpenTelemetry ;
- X-Ray est d’ailleurs aujourd’hui plus ou moins capable d’ingérer le format OpenTelemetry en plus de son format natif ;
- les créateurs de
tracing, dans leur infinie bonté, nous ont également offerttracing_opentelemetrypour automatiquement traduire les spanstracingen spansotel.
Tout cela fait d’OpenTelemetry un intermédiaire intéressant par lequel passer plutôt que de traiter directement la donnée issue de tracing.
Les pièces manquantes du puzzle #
À ce stade, voilà où on en est :
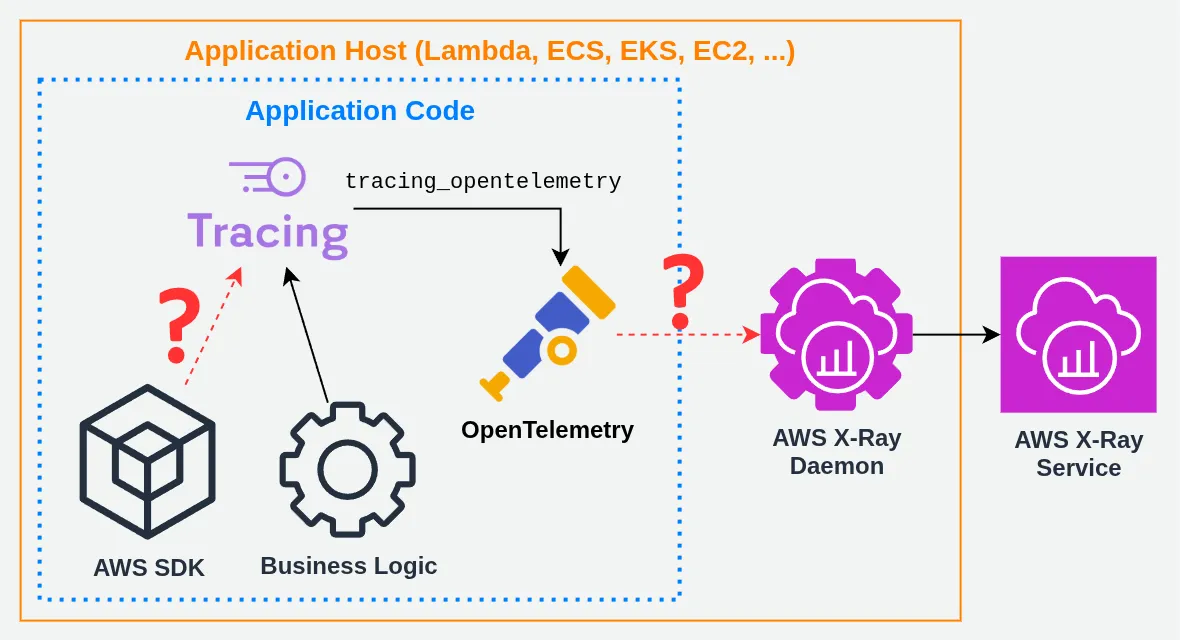
Comme je l’ai dit plus haut, les SDK AWS utilisent tracing en interne, mais ils produisent des spans lacunaires par défaut. Par exemple, ils n’ajoutent pas d’informations comme le nom de la table DynamoDB ou du bucket S3 lors d’appels à ces services. Or, on veut ce genre d’informations dans nos segments X-Ray.
J’ai également dit que le service X-Ray savait (plus ou moins) parler en OpenTelemetry, alors pourquoi s’embêter à traduire dans son format natif pour utiliser le démon ? Pour la faire court, le démon X-Ray reste à ce jour la seule solution acceptable dans un contexte AWS Lambda ! Ce sera le sujet de mon prochain article, patience. 😉
Il ne me reste donc plus qu’à coder les deux points d’interrogation !
Contribution à opentelemetry-aws #
Pour la traduction OpenTelemetry -> X-Ray, j’ai décidé de contribuer sur le projet opentelemetry-aws plutôt que d’écrire une librairie dans mon coin. Ça a pris du temps pour faire merger mon code (en même temps j’ai ajouté 20k lignes et multiplié par 30 la taille de la lib 🤣), encore plus pour faire publier la nouvelle version avec mes ajouts. Mais c’est fait : la communauté est désormais dotée d’une solution pour exporter de l’OTel vers X-Ray ! 🥳
Création de awssdk-instrumentation #
Pour l’instrumentation automatique des SDK AWS, je n’ai pas trouvé d’existant auquel me raccrocher. J’ai donc créé une librairie : awssdk-instrumentation. Notez l’absence de tiret - entre aws et sdk pour que ça ne soit pas confondu avec une librairie AWS officielle !
La librairie permet de gérer l’instrumentation des SDK AWS, et aussi celle du runtime Lambda. L’idée est que l’utilisateur (vous ! 😁) n’ait pas à penser à tout ça et que ça marche tout seul. Dans ma tête, l’expérience idéale c’est : j’initie un truc dans ma fonction main, et je code mon app comme d’habitude.
Résultat #
On a tout :
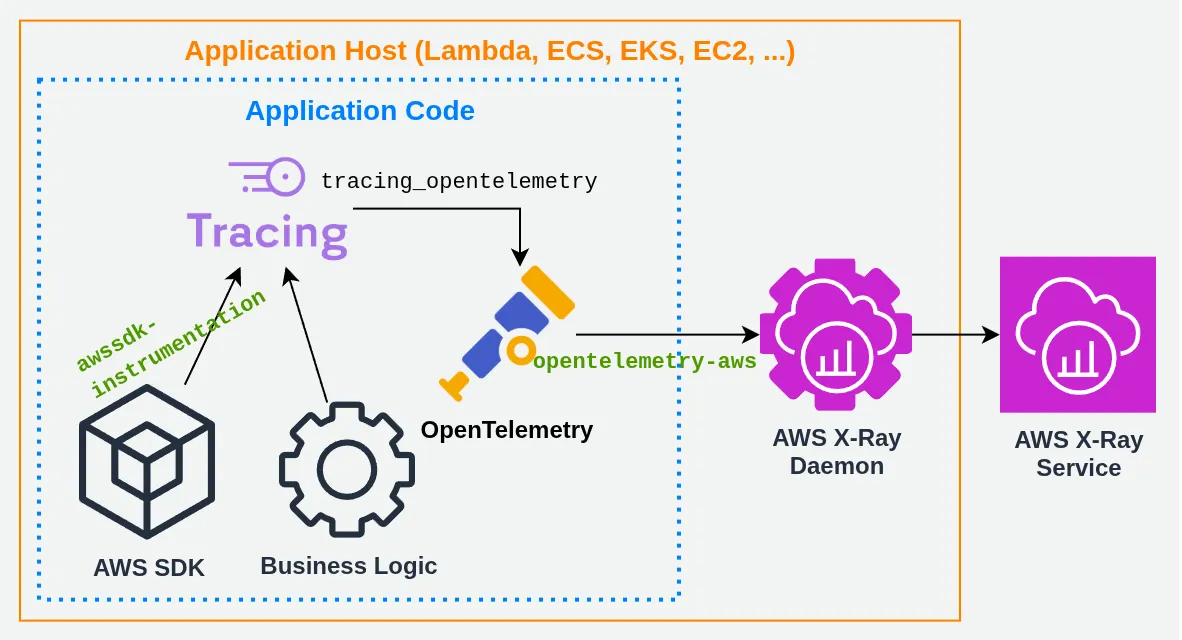
Il reste une seule question… l’expérience utilisateur est-elle aussi compliquée que le schéma ? Fort heureusement, non ! Mais jugez plutôt 😁
Démo de l’UX #
Prenons le code d’exemple fourni par la documentation AWS pour une fonction Lambda avec logging et ajoutons un peu de code pour qu’elle écrive l’événement dans S3 (histoire d’avoir quelque chose à tracer). Cela permet de voir d’où on part :
// Business-logic of our app
// Take the JSON event and dump it with random delay into S3
#[tracing::instrument]
async fn dump_payload_to_s3(payload: &Value) -> Result<(), Error> {
    tracing::info!("Dump Payload invoked");
    simulate_logic().await;
    // Object key = timestamp as string
    let key = std::time::UNIX_EPOCH
        .elapsed()
        .unwrap()
        .as_secs()
        .to_string();
    // Put the payload in S3
    s3().put_object()
        .bucket(std::env::var("DUMP_BUCKET")?)
        .key(key)
        .body(serde_json::to_vec(payload)?.into())
        .send()
        .await?;
    simulate_logic().await;
    Ok(())
}
#[tracing::instrument]
async fn simulate_logic() {
    tracing::info!("Doing stuff...");
    // Random delay for demonstration purpose
    tokio::time::sleep(std::time::Duration::from_millis(rand::random_range(..500))).await;
}

// Boiler-plate to get AWS SDK clients and make them re-usable
// through multiple Lambda invocations
use aws_config::SdkConfig;
use std::sync::OnceLock;
// The SDK Config is shared by all clients (AccessKey, SecretKey, SessionToken)
static AWS_SDK_CONFIG: OnceLock<SdkConfig> = OnceLock::new();
fn aws_sdk_config() -> &'static SdkConfig {
    AWS_SDK_CONFIG.get().unwrap()
}
async fn sdk_config_init() {
    AWS_SDK_CONFIG
        .set(aws_config::load_from_env().await)
        .unwrap();
}
// Returns a singleton S3 client
fn s3() -> aws_sdk_s3::Client {
    static CLIENT: OnceLock<aws_sdk_s3::Client> = OnceLock::new();
    CLIENT
        .get_or_init(|| aws_sdk_s3::Client::new(aws_sdk_config()))
        .clone()
}

// Below is mostly a copy/paste of the documentation example
use lambda_runtime::{Error, LambdaEvent, service_fn};
use serde_json::{Value, json};
#[tracing::instrument(skip(event), fields(req_id = %event.context.request_id))]
async fn handler(event: LambdaEvent<Value>) -> Result<Value, Error> {
    tracing::info!("Rust function invoked");
    let payload = event.payload;
    // Put the payload in S3
    dump_payload_to_s3(&payload).await?;
    let first_name = payload["firstName"].as_str().unwrap_or("world");
    tracing::info!({ %first_name }, "Rust function responds to event");
    Ok(json!({ "message": format!("Hello, {first_name}!") }))
}

#[tokio::main]
async fn main() -> Result<(), Error> {
    tracing_subscriber::fmt()
        .json()
        .with_max_level(tracing::Level::INFO)
        .with_current_span(false)
        .with_ansi(false)
        .with_target(false)
        .init();
    // Init the SDK config once before handling events
    sdk_config_init().await;
    lambda_runtime::run(service_fn(handler)).await
}
Dépendances à utiliser pour déployer le code tel quel
[dependencies]
lambda_runtime = "1"
tokio = { version = "1", features = ["macros", "signal"] }
aws-config = { version = "1", features = ["behavior-version-latest"] }
aws-sdk-s3 = "1"

tracing = "0.1"
tracing-subscriber = "0.3"

serde_json = "1"
rand = "0.10.3"
Première observation : ça fait beaucoup de code “boiler-plate”[3] ! Je vous l’accorde volontiers, ma librairie tente d’ailleurs de résoudre aussi ce point. 😉
Mais surtout, même en cochant la case “X-Ray” lors de la configuration de la Lambda, on n’obtient rien d’intéressant :
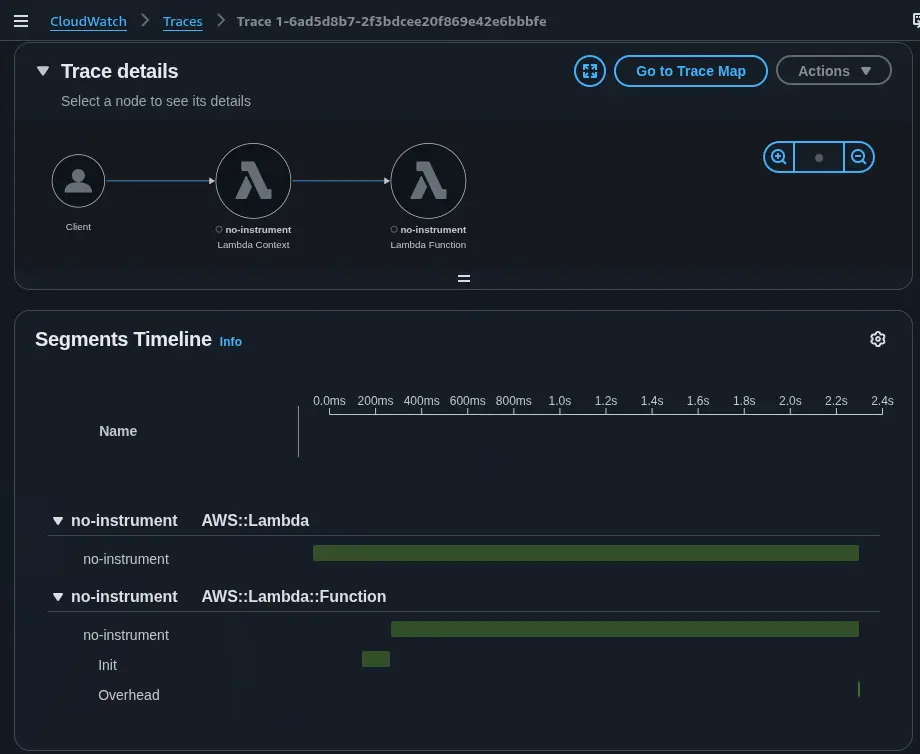
C’est logique : le service Lambda n’a aucun moyen de savoir ce qu’il se passe pendant l’exécution, il peut juste dire quand elle commence et finit.
Quant aux logs, ils apportent un peu de visibilité mais :
- ce n’est pas très visuel, ni très pratique, de devoir faire des soustractions de tête pour essayer de comprendre les délais dans l’exécution ;
- avec les lignes de log qu’on utilise, on sait quand certaines fonctions commencent mais on n’a aucun détail sur leur exécution ou quand elles se finissent ;
- à moins d’activer le
debuglog et se retrouver avec 600 lignes par exécution, on ne sait rien de l’interaction avec S3.
Alors ajoutons à notre lambda le fameux awssdk-instrumentation avec les features qui vont bien :
[dependencies]
awssdk-instrumentation = { version = "0.3", features = ["tracing-backend", "env-lambda", "extract-s3", "export-xray"], default-features = false }
Et changeons le code :
// We keep the business-logic of our app
// Take the JSON event and dump it with random delay into S3
#[tracing::instrument]
async fn dump_payload_to_s3(payload: &Value) -> Result<(), Error> {
    tracing::info!("Dump Payload invoked");
    simulate_logic().await;
    // Object key = timestamp as string
    let key = std::time::UNIX_EPOCH
        .elapsed()
        .unwrap()
        .as_secs()
        .to_string();
    // Put the payload in S3
    s3().put_object()
        .bucket(std::env::var("DUMP_BUCKET")?)
        .key(key)
        .body(serde_json::to_vec(payload)?.into())
        .send()
        .await?;
    simulate_logic().await;
    Ok(())
}
#[tracing::instrument]
async fn simulate_logic() {
    tracing::info!("Doing stuff...");
    // Random delay for demonstration purpose
    tokio::time::sleep(std::time::Duration::from_millis(rand::random_range(..500))).await;
}

// And the example handler from the doc
use lambda_runtime::{Error, LambdaEvent};
use serde_json::{Value, json};
#[tracing::instrument(skip(event), fields(req_id = %event.context.request_id))]
async fn handler(event: LambdaEvent<Value>) -> Result<Value, Error> {
    tracing::info!("Rust function invoked");
    let payload = event.payload;
    // Put the payload in S3
    dump_payload_to_s3(&payload).await?;
    let first_name = payload["firstName"].as_str().unwrap_or("world");
    tracing::info!({ %first_name }, "Rust function responds to event");
    Ok(json!({ "message": format!("Hello, {first_name}!") }))
}

// Boiler-plate can just be generated by a simple macro
awssdk_instrumentation::make_lambda_runtime!(handler, s3() -> aws_sdk_s3::Client);
Notez que tout le “boiler-plate” est remplacé par une petite macro qui demande l’essentiel :
- quel est le nom de la fonction
handler? - quel(s) client(s) du SDK AWS faut-il créer ?
Et tout le reste est généré automatiquement. Vous vous en doutez sans doute, si vous inspectez le code généré, vous retrouverez la même chose qu’avant plus du code pour mettre en place l’instrumentation automatique des SDK, celle du runtime Lambda, le lien avec OTel et celui avec X-Ray.
Notez également que je n’ai pas modifié le moindre caractère sur la partie code métier. Résultats ?
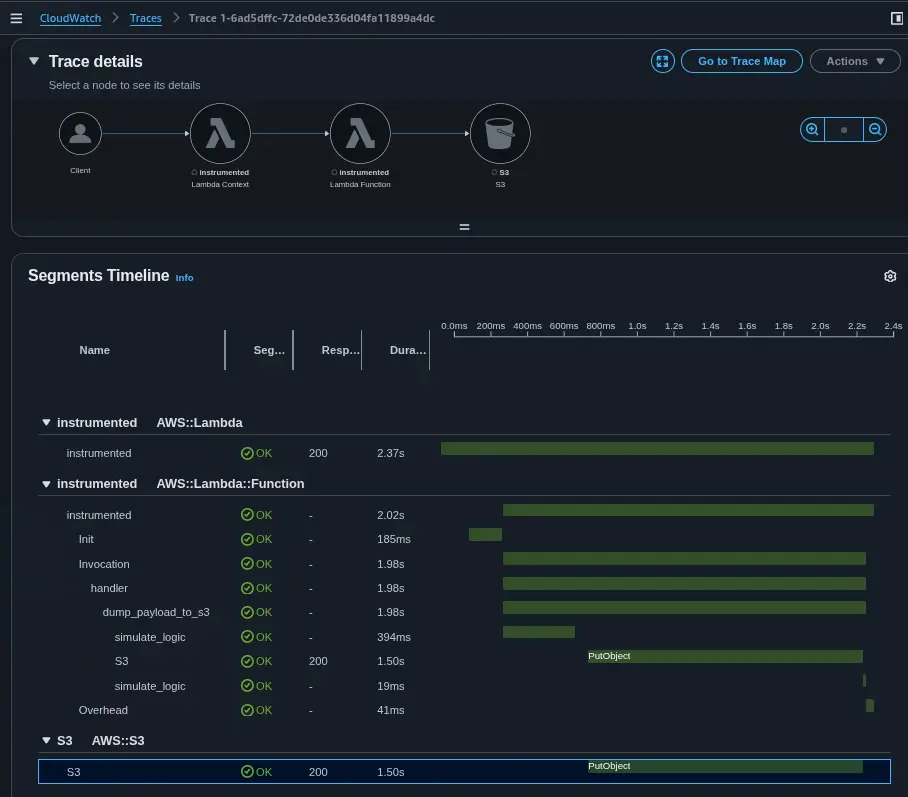
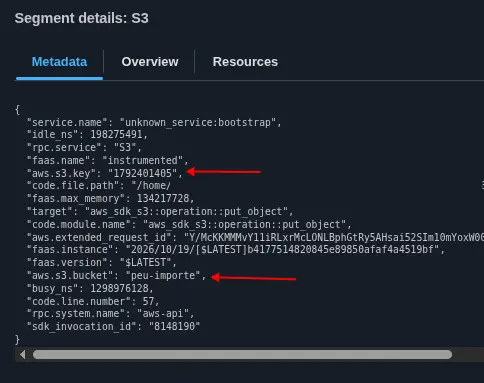
Avec tout ce détail, on sait maintenant exactement le temps passé dans chaque étape de l’exécution de notre lambda ! Et bien entendu, on a aussi beaucoup plus de détails sur chacun des segments en cliquant dessus :
Performances #
Je ferai prochainement un article dédié à ça, mais sachez que l’impact est négligeable. La traduction d’un span OTel en segment X-Ray prend ~2µs, sa transmission au daemon X-Ray ~8µs, soit ~10µs par span. Même si votre code génère des traces d’une cinquantaine de spans (ce qui paraît énorme), vous pouvez vous attendre à un “impact” de 500µs… Autant dire que c’est pas là que ça touche, comme on dit… Surtout quand vous comparez à la concurrence 😏
Contactez-moi #
Si vous faites (ou voulez faire !) du Rust sur AWS et que vous souhaitez en discuter, n’hésitez pas à me contacter.
dans le monde de l’observabilité, un span couvre une période de l’exécution du programme (il a un timestamp de début et de fin), typiquement des fonctions importantes ou des interactions avec des bases de données ou autres systèmes extérieurs. C’est ce que X-Ray appelle Segment ou Sous-Segment. ↩︎
AWS garde le service X-Ray, mais déprécie le SDK d’instrumentation ainsi que le démon. Sauf que la date de fin de support initialement annoncée a été finalement retirée de la documentation. De fait, pour l’instant le démon X-Ray reste là. L’observateur taquin que je suis ne pourra s’empêcher de faire le rapprochement avec le fait que la proposition de remplacement poussée par AWS (le fameux ADOT) est nulle à chier et que personne n’en veut. ↩︎
Du code nécessaire pour la plomberie applicative, comme la communication avec le service Lambda, l’instanciation des clients SDK, … Bref du code qu’on est obligé d’écrire mais qui n’a aucune valeur ajoutée business. ↩︎